# 索引
# 数据库索引的定义和作用
定义: 索引(Index) 是数据库管理系统中的一种数据结构,它以特定的方式存储数据表中的某些字段(列)的信息,以加快数据检索的速度。索引类似于书籍的目录,通过它可以快速找到所需的信息,而无需扫描整个表。
作用:
- 提高查询速度:索引大大加快了 SELECT 查询的速度,尤其是对大表的查询。例如,搜索、排序和分组操作可以显著受益于索引。
- 提高数据的检索效率:通过减少磁盘 I/O 操作,索引能有效提升数据检索的效率。
- 强制唯一性:唯一索引(Unique Index)可以确保表中某列的值是唯一的,帮助维持数据的完整性。
- 加快表连接速度:在进行表连接(JOIN)操作时,索引能够加速连接操作。
- 提升排序和分组性能:在执行 ORDER BY 和 GROUP BY 语句时,索引能够加速这些操作。
索引的类型
- 主键索引(Primary Key Index):
- 唯一标识表中的记录,不允许空值。每个表只能有一个主键索引。
- 唯一索引(Unique Index):
- 保证索引列的所有值是唯一的,可以有空值。一个表可以有多个唯一索引。
- 普通索引(普通索引 / Non-Unique Index):
- 最基本的索引类型,不强制唯一性,允许重复值。
- 复合索引(Composite Index / 多列索引):
- 包含多个列的索引,通过组合多个列来创建索引,提高组合查询的效率。
- 全文索引(Full-Text Index):
- 用于全文搜索,适合大文本字段的搜索。支持 MATCH AGAINST 操作。
- 空间索引(Spatial Index):
- 用于地理空间数据类型的索引,适用于空间数据的快速查询(如点、线、多边形等)。
- 哈希索引(Hash Index):
- 使用哈希表实现的索引,适用于等值查询,不适用于范围查询。主要用于 Memory 引擎表。
- 聚簇索引(Clustered Index):
- 数据行的物理顺序与索引的逻辑顺序一致。InnoDB 存储引擎的主键索引就是一种聚簇索引。
- 非聚簇索引(Non-Clustered Index):
- 索引顺序与数据行的物理顺序无关,每个索引项指向实际数据行的位置。MyISAM 引擎中的索引是非聚簇索引。
- 主键索引(Primary Key Index):
索引的基础知识回顾
- 创建索引:使用 CREATE INDEX 语句来创建普通索引和唯一索引,使用 ALTER TABLE 来创建主键索引。
- 删除索引:使用 DROP INDEX 语句。
- 查看索引:使用 SHOW INDEX FROM table_name 或 EXPLAIN 语句来查看表的索引情况。
- 优化查询:通过分析和调整索引,可以显著优化查询性能。
- 理解和使用索引是数据库优化的重要环节,可以显著提升数据库系统的性能。
# 索引失效
在 MySQL 中,索引能够显著提高查询的效率,但在某些情况下,索引可能会失效,从而导致查询性能下降。以下是一些常见的 MySQL 索引失效场景及其原因:
- 使用函数或操作符:
- 在查询条件中对索引列使用函数(如 LEFT (column, 3) = 'abc')或操作符(如 column + 1 = 5)会导致索引失效,因为 MySQL 无法对函数或操作符的结果进行索引。
- 类型不匹配:
- 如果查询条件中的数据类型与索引列的数据类型不匹配,索引可能会失效。例如,索引列是字符串类型,但在查询中使用了数值类型的条件。
- 隐式转换:
类似于类型不匹配,如果 MySQL 需要对索引列进行隐式转换(如将字符串转换为数值),索引也会失效。 - 前导通配符:
- 使用 LIKE 查询时,如果在通配符 % 或 _ 之前没有任何字符(如 LIKE '% abc'),索引将无法使用。这是因为 MySQL 无法确定从哪里开始扫描索引。
- 不符合最左前缀原则:
- 对于复合索引,如果查询条件不符合最左前缀原则,索引将失效。例如,复合索引 (a, b, c),查询条件必须从 a 开始,如 (a, b) 或 (a),而不能仅使用 b 或 c。
- OR 条件:
- 在查询中使用 OR 条件,如果每个条件字段上没有独立的索引,索引会失效。例如,WHERE column1 = value1 OR column2 = value2,只有在 column1 和 column2 上都有独立索引时,索引才会生效。
- 范围查询影响后续列:
- 在复合索引中,如果其中一个列使用了范围查询(如 BETWEEN、<、>),则该列之后的索引列将无法使用。例如,复合索引 (a, b),查询 WHERE a > 5 AND b = 10 中,索引 b 将失效。
- NULL 值判断:
- 对于索引列的 IS NULL 或 IS NOT NULL 判断,MySQL 通常不会使用索引,因为 NULL 值在索引中的处理有特殊情况。
- 表扫描:
- 在某些情况下,即使存在索引,MySQL 优化器也可能选择进行全表扫描(Table Scan),例如当表非常小,或统计信息显示使用索引的代价更高时。
- 通过注意上述这些情况,可以有效避免 MySQL 索引失效,确保查询性能的优化。在实际应用中,使用 EXPLAIN 语句可以帮助检查查询是否使用了索引,并进一步优化查询
- 使用函数或操作符:
# 浏览器执行流程
- 在浏览器地址栏输入 192.168.1.1 访问网页时,首先执行的操作并不是直接建立 TCP 连接,而是执行 DNS 解析(域名解析)。不过,由于 192.168.1.1 是一个典型的私有 IP 地址,这个过程会稍微不同。以下是更详细的步骤:
- 地址解析(跳过 DNS):
由于 192.168.1.1 是一个直接的 IP 地址,浏览器跳过了 DNS 解析步骤,因为不需要将域名转换为 IP 地址。
2. 建立 TCP 连接:
浏览器向 192.168.1.1 的默认 HTTP 端口(通常是 80)或 HTTPS 端口(通常是 443)发起一个 TCP 连接请求。这个过程涉及三次握手,以确保连接的可靠性。
3. 发送 HTTP 请求:
一旦 TCP 连接建立成功,浏览器会发送一个 HTTP 请求(例如 GET 请求)到该 IP 地址上的 Web 服务器。
4. 服务器处理请求并响应:
192.168.1.1 上的 Web 服务器处理请求,并返回相应的网页数据。
5. 浏览器接收并渲染页面:
浏览器接收服务器返回的网页数据,并开始渲染网页内容。
所以,尽管在这个特殊情况下(直接输入 IP 地址),DNS 解析步骤被跳过,但建立 TCP 连接依然是后续的关键步骤。
# 商业智能系统
- 商业智能系统主要包括以下四个主要阶段:
- 数据预处理:这是整个流程的起始点,涉及从不同来源收集原始数据,并通过抽取(Extract)、转换(Transform)和加载(Load),即 ETL 过程,对数据进行清洗、格式化和整合,确保数据质量,以便后续分析使用。
- 建立数据仓库:创建一个集中化的数据存储环境,用于存储经过预处理的大量历史数据。数据仓库支持高效的数据管理和查询,为复杂的分析任务提供坚实的基础。
- 数据分析:利用统计学方法、联机分析处理(OLAP)和数据挖掘技术等手段,从数据中发现模式、趋势和关联性。这一阶段是商业智能系统智能化的核心,它能将数据转化为可操作的洞察。
- 数据展现:将分析结果以图表、报告、仪表板等形式直观地展示给决策者和业务用户,使他们能够快速理解复杂的数据信息,从而基于数据驱动的洞察做出决策。这一步骤通常还包括数据可视化工具的应用,以便用户交互式地探索数据。这四个阶段共同构成了商业智能系统的核心流程,帮助企业更好地理解和利用其数据资产,提高决策效率和质量。
# 面向对象分析与设计区别
- 面向对象分析(Object-Oriented Analysis, OOA)主要关注于理解并捕获问题领域的需求,识别参与者、用例以及领域对象,建立问题域的静态结构和动态行为的模型。
- 面向对象设计(Object-Oriented Design, OOD)则是在分析的基础上,关注如何将问题域模型转化为可实现的解决方案,包括类的设计、接口设计、数据库设计等,更侧重于软件结构和组件的实现细节。因此,两者之间存在明显的区别。
# 案例题
# 第一题
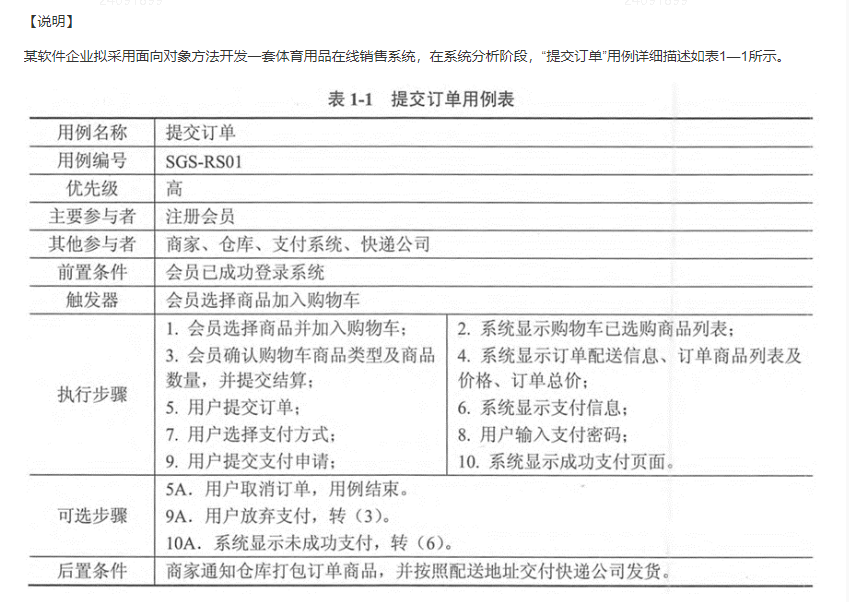
- 【问题 1】 (9 分)
面向对象系统开发中,实体对象、控制对象和接口对象的含义是什么?
在面向对象的系统开发中,实体对象、控制对象和接口对象是三个重要的概念,它们在系统设计和实现中扮演不同的角色:
- 实体对象(Entity Objects):
含义:实体对象表示系统中的业务实体或数据对象,它们通常与数据库中的表或记录相对应,包含业务数据和行为。
作用:管理和存储系统中的核心数据,反映业务逻辑中的实际事物。
示例:在电商系统中,会员、商品、订单等都是实体对象。
2. 控制对象(Control Objects):含义:控制对象负责管理系统中的业务逻辑和控制流程,它们通常用来协调实体对象和接口对象之间的交互。
作用:处理复杂的业务逻辑和控制流程,执行用例的具体步骤。
示例:在提交订单的过程中,控制对象可能负责处理订单提交、支付流程等。
3. 接口对象(Boundary Objects):含义:接口对象是系统与外部用户或其他系统之间的交互接口,通常用于处理用户输入和输出。
作用:提供与用户或外部系统交互的界面,管理用户的请求和系统的响应。
示例:在电商系统中,购物车页面、支付页面等都是接口对象。
- 【问题 2】 (10 分)
面向对象系统分析与建模中,从潜在候选对象中筛选系统业务对象的原则有哪些?
在面向对象的系统分析与建模中,从潜在候选对象中筛选系统业务对象的原则如下:
相关性原则:业务对象必须与系统的主要功能和业务需求密切相关,能够准确反映系统的业务逻辑。
独立性原则:业务对象应具有独立的身份和明确的职责,避免冗余和重复。
可识别性原则:业务对象应易于识别和理解,通常对应于现实世界中的具体事物或概念。
持久性原则:业务对象通常需要在系统中持久存储,并能够跨会话存在,例如数据库中的记录。
可操作性原则:业务对象应具有明确的行为和操作,与系统的功能需求相对应。
可复用性原则:优先选择那些在系统的多个部分可以复用的对象,提升系统的灵活性和扩展性。
- 【问题 3】(6 分)
根据题目所示 “提交订单” 用例详细描述,可以识别出哪些业务对象?
根据题目所示 “提交订单” 用例的详细描述,可以识别出以下业务对象:
- 会员(Entity):代表系统中的用户,需要登录系统进行操作。
- 商品(Entity):可加入购物车的产品。
- 购物车(Entity):存储会员选择的商品列表。
- 订单(Entity):包含提交后形成的订单信息。
- 配送信息(Entity):与订单关联的配送地址等信息。
- 支付系统(Boundary):处理用户支付相关操作的外部系统。
- 支付密码(Entity):用户为完成支付输入的密码。
- 支付申请(Entity):用户提交的支付请求。
- 成功支付页面(Boundary):显示支付成功的信息界面。
- 商家(Entity):负责商品的管理和发货。
- 仓库(Entity):负责打包和准备发货的商品存储地点。
- 快递公司(Entity):负责将订单商品送达会员指定的配送地址。
- 这些业务对象共同构成了提交订单用例中的核心部分,涵盖了从商品选择到订单支付完成的整个流程。
# 第二题
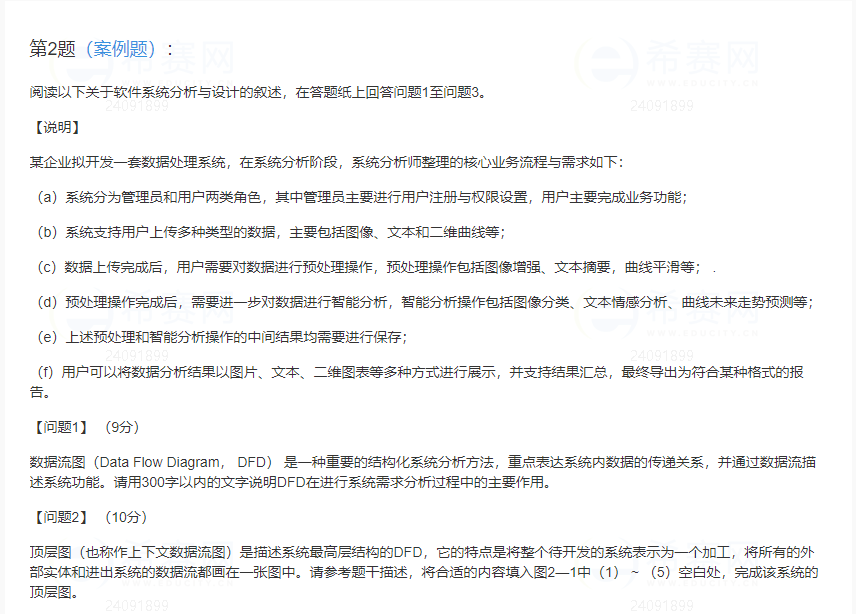
数据流图(DFD)在系统需求分析过程中主要作用是:
可视化系统流程:DFD 通过图形方式展示系统中数据的流动和处理过程,使系统的逻辑结构一目了然。它使用箭头表示数据流、方框表示数据存储、圆圈表示处理过程和矩形表示外部实体,帮助用户和开发人员理解系统的工作机制。
明确功能需求:通过分解系统的各个功能模块,DFD 能够明确每个模块的输入、处理和输出。这有助于识别系统需要实现的具体功能和各功能之间的关系,为进一步的系统设计和开发提供清晰的指导。
识别数据交互:DFD 展示了系统内部以及系统与外部实体之间的数据交互过程,明确了数据的输入来源、处理路径和输出目标。这对于定义系统接口、确保数据完整性和一致性非常重要。
简化复杂系统:DFD 可以将复杂的系统逐级分解为多个层次,每个层次展示系统的一部分功能,使分析人员可以逐步理解和描述系统的各个部分,降低理解和分析的难度。
沟通工具:作为一种直观的图形化工具,DFD 可以促进分析人员、开发人员和客户之间的沟通,确保各方对系统需求有一致的理解。它能够有效减少因需求不明确或理解不一致而导致的开发偏差和错误。
- 总之,DFD 在系统需求分析过程中通过可视化、明确功能、识别交互、简化复杂性和促进沟通等方面发挥重要作用,是系统分析和设计中不可或缺的工具。